テキストか、画像か? AI 映像生成における時間と品質のトレードオフ
AI 映像のプロジェクトは、いつも同じ問いから始まります。「生成ボタンを押す前に、どれだけ時間をかけるべきか?」
数か月の制作を経て、私はシンプルなメンタルモデルに落ち着きました。かけた時間と得られる品質の 2 軸で、3 つの作り方を比べるものです。テキストベースの AI 生成、画像ベースの AI 生成、そして従来の制作です。
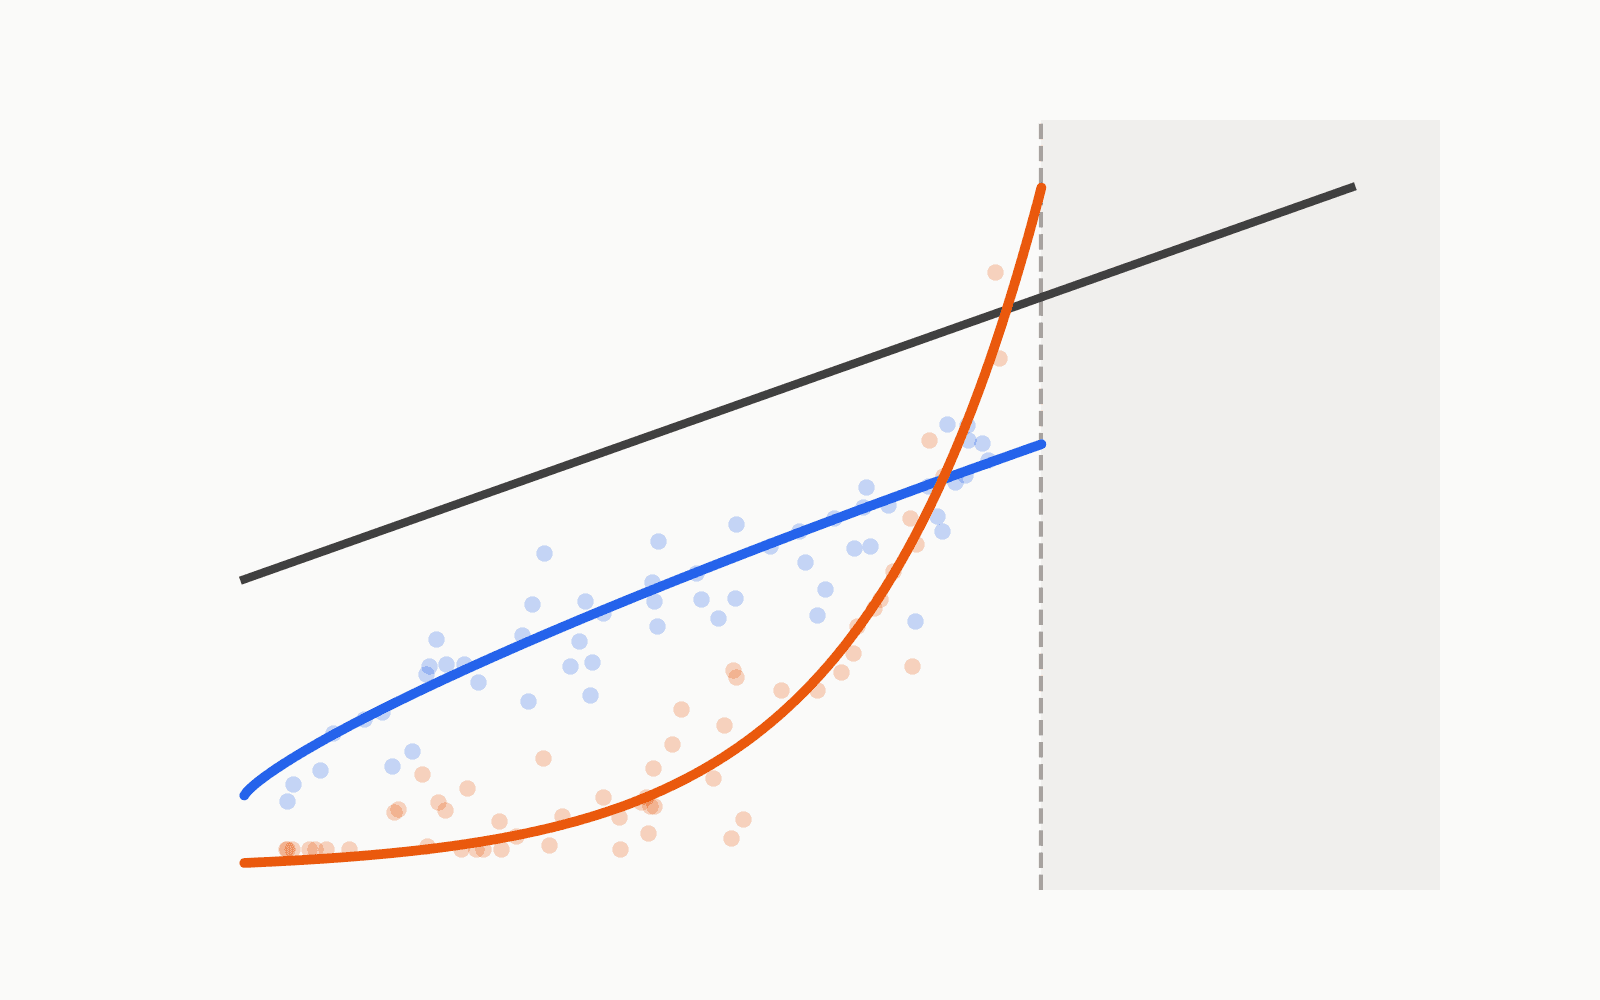
以下の曲線はあくまで概念図で、実測データではなく経験にもとづいて描いたものです。それでも、どのアプローチを選ぶか判断するうえで役に立ってきました。
スピードか、コントロールか:2 つの入り口
画像ベース:コントロールが効くが、時間がかかる
画像ベースの生成では、モデルに参照用の画像を渡します。その画像の設計と準備に先に時間を使い、用意するフレームや参照が多いほど時間もかかります。
- ストーリーボード → 映像
- 開始フレーム + 終了フレーム → 映像
- 映像 → 映像
テキストベース:すぐ試せるが、コントロールは弱い
テキストベースの生成では、欲しいものを言葉で説明し、ショットの設計はモデル(またはその手前の LLM)に任せます。
- テキスト → 映像
- アイデア → LLM によるプロンプト書き換え → 映像(時間を増やさずに結果が良くなる)
- 長い脚本 → 多段パイプライン(ショットに分割し、それぞれを生成)→ 映像(長い脚本でも品質を落とさずに扱える)
時間と品質

-
従来の制作: 初期コスト(セットアップ、アセット、パイプライン)が高く、その後は品質にほぼ比例して時間が増えていきます。遅いですが、明確な上限はありません。
-
テキストベース(オレンジ): 立ち上がりが速く、ごくわずかな時間でそこそこの結果が得られます。しかし品質を求めるほどコストは急激に上がり、モデルの上限に近づくと一気に跳ね上がります。品質を一段上げるたびに、生成のやり直しとプロンプト調整が増えるからです。プロトタイピングやアイデアの検証に最適です。
-
画像ベース(青): 参照画像、ストーリーボード、開始・終了フレームを準備するぶん、初期投資は大きくなります。しかしコストの伸びは緩やかで、上限まで管理しやすいままです。構図、動き、スタイルをしっかりコントロールしたいときは、こちらのほうが割に合います。
-
交差点: 目標とする品質が低いうちはテキストベースのほうが安く済みます。交差点を越えると、同じ品質を画像ベースのほうが短い時間で達成できます。
品質の上限

どのモデルにも品質の上限があります。見た目の精細さだけでなく、指示にどれだけ正確に従えるかも含めて、現時点で安定して出せる最高品質のことです。上限より下なら、たいてい AI のほうが速い。上限より上は、どれだけプロンプトを工夫しても、どれだけ参照を用意しても届かず、従来の制作しか選択肢がありません。
ただし、この上限は固定ではありません。モデルの世代が進むたびに上がり、AI が適した領域は広がり続けています。
現実のばらつき

ここまでの曲線は平均値です。実際の AI 生成には大きなばらつきがあり、個々の結果は期待される曲線のまわりに広く散らばります。
-
運が悪いケース(青): すべてのショットの参照フレームを時間をかけて描いたのに、出力は使い物になりませんでした。大きな投資に対して低い品質。こういうことは起こります。
-
運が良いケース(オレンジ): テキストの脚本だけを渡したら、ほとんど時間をかけずに上限近くの驚くほど良い結果が出ました。これも起こります。
-
AI 制作の本質的なリスク: このランダム性のせいで、大きく投資しても完全に失敗することがあります。時間を大きく賭けても、報われるとは限りません。
-
従来の制作がこれにうまく対処できる理由: 従来のワークフローははるかに決定論的です。成果は投入したスキルと時間にずっと素直に連動し、大きな投資がまるごと無駄になるような急な崩れがありません。幸運な上振れは少ないものの、致命的な下振れもずっと少ないのです。
実践的な結論: 失敗しても痛くない安価な探索にはテキストベースを使う。予測しやすいコントロールとばらつきの小ささが必要になったら画像ベースに切り替える。モデルのランダム性に賭けるにはリスクが大きすぎるときは、従来の制作に戻る。
これは「エンドツーエンド vs. ハイブリッド:AI 映像パイプライン」で書いた、より大きな問いにつながります。アイデアとピクセルのあいだに、どれだけの構造を挟むのか。テキストベースと画像ベースの生成は、同じスペクトラム上の 2 つの点なのです。